Nginx 服务器
主要作者
本文编写中
Web server 不能失去 Nginx,就如同西方不能失去耶路撒冷
—— @Cherrling
Nginx 是一个高性能的开源 Web 服务器和反向代理服务器,以稳定性高、性能优异、并发能力强等优势被广泛使用。
如果你只是需要简单快速的拉起一个网站,或许也可以试试 Caddy,它是一个更加简单的 Web 服务器。
安装
Nginx 可以直接从 Debian APT 源安装。其许多常用模块被打包在额外的软件包中,它们的包名以 libnginx-mod- 开头,你可以根据需要选装。同时,Debian 也将模块按常用程度分为了四个不同的 meta 软件包,可以根据需要安装这些 meta 软件包:
nginx-core 和 nginx-full 的内置模块是一样的,而 nginx-light 的内置模块(编译到 nginx 二进制中)更少,缺少 ngx_http_geo_module 等可能会被用到的模块,并且这些模块没有单独的模块软件包,因此如果需要减小 nginx 安装和加载的模块量,可以安装 nginx-core,并自行安装其他需要的模块软件包。
nginx-extras 的内置模块显著更多,且通过软件包依赖关系引入了大量的动态模块,适合需要「一键确保所有功能可用」的场景(这种情况非常少见,一般不推荐无脑安装所有模块)。
你可以随时运行 nginx -V 查看你当前安装的 Nginx 包含了哪些模块:
# ...
--with-http_ssl_module
--with-http_stub_status_module
# ...
--with-http_geoip_module=dynamic
--with-http_image_filter_module=dynamic
# ...
--add-module=/build/nginx/sb-modules/ngx_brotli
--add-module=/build/nginx/sb-modules/zstd-nginx-module
# ...
--add-dynamic-module=/build/nginx/debian/modules/http-lua
--add-dynamic-module=/build/nginx/debian/modules/http-subs-filter
# ...
在以上示例中:
--with-*是 Nginx 官方的模块,编译进nginx二进制本体;--without-*表示该官方模块没有被编译,从而也无法使用(本例未包含);--with-*=dynamic表示 Nginx 官方模块被编译成为.so文件,在运行时动态加载;--add-module=*是编译进nginx二进制的第三方模块;--add-dynamic-module=*表示编译成动态链接库的第三方模块。
如果有特殊的需求,也有其他的选择:
- Nginx.org 源 提供了最新主线和稳定版本的 Nginx。
- n.wtf 提供了最新版本的 Nginx,并内置了 Brotli、QUIC(HTTP/3)等支持。特别地,n.wtf 版本的 Nginx 采用 Debian 的打包方式,是 Debian 官方包很好的替代,也因此在 USTCLUG 内部广泛使用。
- OpenResty 提供了基于 Nginx 的高性能 Web 平台,内置了 LuaJIT 支持。用户可以编写 Lua 脚本来扩展 Nginx 的功能。
科大镜像站 提供了以上三种源的镜像,分别位于 nginx、sb(n.wtf)和 openresty。
管理 Nginx 的常用命令:
sudo nginx -t # 检查配置文件是否正确
sudo nginx -s reload # 不停机重新加载配置文件
sudo nginx -s stop # 停止 Nginx
sudo nginx -s quit # 安全停止 Nginx(完成当前请求后停止)
对于使用 systemd 管理 Nginx 服务的系统,也可以使用:
配置文件
对于 Debian & Ubuntu 来说,nginx.conf 的内容一般包含:
配置 Nginx 主要涉及到三个目录,分别是 /etc/nginx/nginx.conf、/etc/nginx/sites-available 和 /etc/nginx/sites-enabled。
nginx.conf是 Nginx 的主配置文件,它包含了 Nginx 的全局配置。sites-available目录下存放的是所有的站点配置文件。sites-enabled目录下存放的是启用的站点配置文件的符号链接。
一般情况下,我们不在 nginx.conf 文件的 http 块中直接编写站点信息,而是在 sites-available 目录下创建一个新的配置文件,然后在 sites-enabled 目录下创建一个符号链接。如果要暂时下线某个站点,只需要删除 sites-enabled 目录下的符号链接即可,而不需要删除配置文件。
从 Nginx 的角度来看,唯一的区别在于来自 conf.d 的文件能够更早被处理,因此,如果你有相互冲突的配置,那么来自 conf.d 的配置会优先于 sites-enabled 中的配置。
!!! note "其他发行版和 Nginx 官方的配置" {#nginx-configuration-layouts}
对于其他发行版和官方源来说,配置中则不包含 `sites-available` 和 `sites-enabled`,而是只会 `include` `conf.d` 目录:

```nginx
http {
    # ...
    include /etc/nginx/conf.d/*.conf;
}
```

此时,你需要将你编写的配置文件放置于 `/etc/nginx/conf.d` 目录下,但当你需要禁用某些内容时,必须将其移出文件夹、删除或进行更改。当然,你也可以自己创建 `sites-available` 和 `sites-enabled` 目录,然后在 `nginx.conf` 中引入。
重新加载配置
修改配置文件后,别忘了重新加载 Nginx 配置,否则修改不会生效。
你可以先检查配置文件是否正确:
如果没有问题,就重新加载配置文件:
需要注意的是,如果配置文件中存在错误,重新加载的时候会报出这些错误,然后 Nginx 会以旧的配置文件继续运行。
??? note "Nginx 的主进程与工作进程的设计" {#nginx-process-model}
Nginx 采用了主进程(master process)和工作进程(worker process)的设计。主进程负责读取配置、打开端口、管理工作进程,而工作进程则负责处理实际的请求。当你向主进程发送 SIGHUP 信号时(重新加载配置文件),主进程先验证新的配置,成功后会启动新的工作进程来应用新的配置,并且让旧的工作进程停止接受新连接,处理完成已有的连接之后再退出,因此正在处理的请求不会被突然中断。
指令、变量与模块
Nginx 的配置由一系列的指令(directive)组成。directive 有两种:简单 directive 和块 directive。在上面的例子中,http 块就是一个块 directive,而 include 则是简单 directive。
Nginx 的配置还支持变量。在之后的例子中,$host、$remote_addr、$uri 等都是变量,Nginx 会在处理请求的时候将它们替换为实际的值。用户也可以用 set 指令来定义自己的变量:
Nginx 是模块化的服务器,其中 ngx_http_core_module 提供了基础的让 Nginx 提供 HTTP 服务的功能(包括 http 块)。Nginx 也不仅限于 HTTP 服务——可以转发 TCP 和 UDP 流量,甚至是当邮件服务器,或者 RTMP 直播服务器等。这些功能都是通过不同的模块来实现的。用户也可以自己编译安装第三方模块来扩展 Nginx 的功能。如果使用了 Debian 提供的 Nginx 包,那么可以使用 Debian 编写的一些第三方模块,这些模块以 libnginx-mod- 前缀开头;如果要自行编译模块,需要安装 nginx-dev 包。
Nginx 文档 是非常重要的参考资料,其包含了:
- 按字母序排序的 directive 列表文档
- 按字母序排序的变量列表文档
- 官方模块的列表文档
其中每个 directive 和变量都包含了详细的说明。
基本设置
本节介绍后续内容未涉及的重要设置。
工作进程设置与优化
在 nginx.conf 中,Debian 打包的 nginx 对工作进程的默认设置如下:
worker_processes auto;
worker_cpu_affinity auto;
# 省略其他指令

events {
        worker_connections 768;
        # multi_accept on;
}
这表示:
- 开启和当前 CPU 核心数相同的工作进程(
worker_processes),并且将每个进程绑定在不同的核心上(worker_cpu_affinity)。 - 每个工作进程最多同时处理 768 个连接(
worker_connections)。
对生产环境来说,以上的参数设置可能是不够的。例如对一台分配了 4 核心的虚拟机,按照上述设置,其最多只能同时处理 3072 个连接,对很多业务来说在高峰期都是不够用的,因此需要根据对同时连接数的估计、系统核心数量等来设置 worker_connections。作为参考,科大镜像站的 worker_connections 设置为 32767,并有 80 个 CPU 核心,每个核心一个工作进程。
!!! note "那 multi_accept 呢?" {#multi-accept}
在 Linux 下,nginx 默认使用 epoll。[`multi_accept`](https://nginx.org/en/docs/ngx_core_module.html#multi_accept) 开启后,每次 nginx epoll 都会尽可能多地 accept 新连接,而不是一个一个来。在一部分场景下可能有效果,但是这也会让某个 worker 一次性抢到太多的连接,导致负载不均等问题。

相比之下,更推荐的优化是在 `server` 块(下文介绍)的 `listen` 指令添加 [`reuseport` 参数](https://nginx.org/en/docs/http/ngx_http_core_module.html#reuseport),让内核将新连接均衡到不同的工作进程上(而不是每个工作进程在有新连接时一起被唤醒抢夺连接——这也被称为[「惊群」(Thundering herd)问题](https://en.wikipedia.org/wiki/Thundering_herd_problem))。
!!! warning "调整文件描述符数量限制" {#file-descriptor-limit}
每个进程能够打开的文件数量是有限制的。对 Shell,可以使用 `ulimit -S -n` 和 `ulimit -H -n` 分别查看 soft limit 和 hard limit;对已有的进程也可以查看 `/proc/<PID>/limits` 文件。

其中 soft limit 直接限制了文件数量,但是这个值是允许动态调节的,只要比 hard limit 小即可。默认情况下,为了保证使用 [select(2)][select.2] 的应用的兼容性,进程的文件描述符 soft limit 都是 1024(详见 [systemd issue #25478](https://github.com/systemd/systemd/issues/25478))。由于每个 TCP socket 在 nginx 中都会至少使用一个文件描述符,因此如果调大了 `worker_connections`,那么基本上也必须调整这一项 soft limit 设置。Nginx 中对应的设置为 [`worker_rlimit_nofile`](https://nginx.org/en/docs/ngx_core_module.html#worker_rlimit_nofile),因为反向代理、提供本地文件等还需要开启额外的文件,一般建议至少设置为 `worker_connections` 的两倍。

如果使用 systemd,也可以调整 `nginx.service`,添加 `LimitNOFILE` 参数。
!!! tip "使用 aio 避免工作进程阻塞" {#use-aio}
默认配置下,Nginx 的工作进程会打开、读取需要的文件,但是 POSIX 默认的文件 API(`open()`、`read()` 等)是同步的——这意味着,如果 IO 处理的速度较慢(例如在机械硬盘上),那么对应的工作进程在调用文件 API 时就无法处理其他的请求,导致响应的延迟增大。
尽管 Linux 提供了内核级别的 AIO(异步 IO)的支持(可参考 [libaio](https://pagure.io/libaio)),但是条件较为苛刻:AIO 请求需要使用 `O_DIRECT` 绕过内核的 page cache(对非常快速的 NVMe 设备来说,这么做可能是必要的,但是对慢速设备来说是弊大于利的),并且 `O_DIRECT` 访问要求对齐,否则可能会阻塞住。因此除非存储设备非常快,否则不建议使用。在此类场景下,一种常见的解决方式是创建专用的线程池,将 IO 请求 offload 给这个线程池,避免阻塞其他的任务,包括 POSIX AIO(由 glibc 在用户态实现)和 Nginx 都支持这种方式。
[`aio`](https://nginx.org/en/docs/http/ngx_http_core_module.html#aio) 指令支持基于 Linux 内核 AIO 和线程池这两种实现。添加 `aio threads;` 即可。默认**每个工作进程的**线程池为 32 线程,最多排队 65536 个请求,可以使用 [`thread_pool`](https://nginx.org/en/docs/ngx_core_module.html#thread_pool) 指令调整。以下是科大镜像站在开启 `aio threads` 前后的请求主页的 HTTP 延迟情况,可以看到效果十分显著:

此外,Linux 内核目前推荐的异步 IO(包括文件、网络 socket)方式为 io_uring。不过 Nginx 尚未提供对其的支持。
server 块与 location 块
Nginx 配置的 http 块中可以有多个 server 块,每个 server 块定义了一个站点(虚拟主机),Nginx 会根据请求的域名和端口号来匹配对应的 server 块。Nginx 正是通过 server 块来实现多站点配置的。
一个典型的 server 块如下:
location 块嵌套于 server 块中,用于定义如何处理特定 URI 的请求。它是 Nginx 配置中的一个重要部分,允许让 Nginx 根据请求的路径、参数或其他条件来执行不同的操作。一个 server 块中可以有多个 location 块。
!!! tip "URI? URL? Request URI?" {#uri-url-request-uri}
URI(Uniform Resource Identifier,统一资源标识符)包含 URL(Uniform Resource Locator,统一资源定位符)和 URN(Uniform Resource Name,统一资源名称)。其中 URL 大家都非常熟悉,而 URN 则比较少见。URN 的格式类似于 [`urn:isbn:0262510871`](https://web.mit.edu/6.001/6.037/sicp.pdf),用于标识资源(这里是一本书)的名称。因为 URN 很少见,在绝大部分场景下,URI 和 URL 可以视为同义词。

而 Request URI 是 [HTTP 标准 RFC 2616](https://www.rfc-editor.org/rfc/rfc2616) 中规定的:

```
Request-URI    = "*" | absoluteURI | abs_path | authority
```

即 HTTP 请求第一行中在方法(如 GET、POST 等)后面的部分,例如:

```http
GET /path/to/something?query=string HTTP/1.1
```

这里的 `/path/to/something?query=string` 就是 Request URI。在 Nginx 中,由 [`$request_uri`](https://nginx.org/en/docs/http/ngx_http_core_module.html#var_request_uri) 变量表示。同时,Nginx 会对用户提供的 Request URI 进行归一化(处理 `%xx` 编码、`..` 等),然后将归一化后的路径存储在 [`$uri`](https://nginx.org/en/docs/http/ngx_http_core_module.html#var_uri) 变量中。`location` 块的匹配也是基于归一化后的 `$uri` 变量进行的。
一个 location 块的基本结构如下:
其中可选的 modifier 用于指定匹配方式(例如精确匹配、正则匹配等),默认不填写的话则为前缀匹配,详细介绍见下面的 Location 匹配部分。
站点配置简介
默认的站点配置文件在 /etc/nginx/sites-available/default,你可以直接编辑它——以下为去除了所有注释的默认版本:
server {
    listen 80 default_server;
    listen [::]:80 default_server;

    root /var/www/html;
    index index.html index.htm index.nginx-debian.html;

    server_name _;

    location / {
        try_files $uri $uri/ =404;
    }
}
这个配置文件中定义了一个完整的 server 块。server 块中的指令如下:
listen:该默认站点在所有的 IPv4 和 IPv6 上监听 80 端口。root:根目录是/var/www/html。index:在处理 URL 结尾为/的请求时,使用的默认的首页文件是index.html、index.htm和index.nginx-debian.html;Nginx 会按顺序查找这些文件,找到第一个存在的文件后返回给客户端。server_name:一个约定俗成的“默认服务器”名称_。location /:处理所有以/开头的请求。try_files $uri $uri/ =404;:尝试按顺序查找请求的文件$uri(请求的路径),如果找不到则尝试查找目录$uri/,如果仍然找不到则返回 404 错误。
这时你可以在 /var/www/html 目录下放置你自己的 HTML、CSS、JS 等文件,然后访问 http://localhost 就可以看到你的网站了。
反向代理是代表服务器接收客户端请求、转发到后端、再返回结果的一层中间代理。也可以认为这里的「后端」是反向代理的「上游」。一种常见的需求是让 Nginx 作为其他后端服务的反向代理。可以参考下面的配置:
server {
    listen 80 default_server; # 监听 80 端口
    listen [::]:80 default_server;

    location / {
        proxy_pass http://backend_server:port;  # 替换为后端服务器的地址和端口
        proxy_set_header Host $host;  # 设置主机头
        proxy_set_header X-Real-IP $remote_addr;  # 设置真实客户端 IP
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;  # 设置转发的 IP
        proxy_set_header X-Forwarded-Proto $scheme;  # 设置转发的协议
    }
}
其中对绝大部分后端服务来说,Host 头是必须设置的。
!!! note "约定俗成的 HTTP 请求头" {#http-request-headers}
以上配置中除了 `Host` 是 HTTP/1.1 标准的请求头以外,其他以 `X-` 开头的请求头都是约定俗成的非标准请求头,用于让反向代理(Nginx)传递请求用户的真实 IP 地址和请求协议等信息,否则后端服务只能看到反代本身的 IP 信息。需要注意的是,如果后端服务器没有经过反向代理,或者反向代理配置不正确,那么用户可能会伪造这些请求头,如果此时后端服务错误地信任了这些请求头,就会导致安全问题。
这时访问 http://localhost 就会被转发到 http://backend_server:port。对外部网络来说,Nginx 就是一个反向代理站点。
多站点配置
Nginx 的一个十分炫酷的功能就是可以实现一台主机上运行多个网站,对不同的域名提供不同的服务。这就是所谓的虚拟主机配置。
那么如何实现呢?答案就是 server 块中的 server_name 指令。server_name 指令用于定义服务器的名称,可以是域名、IP 地址、通配符等。我们来看一个典型的示例:
- 对于请求
example.com和www.example.com,Nginx 会使用第一个 server 块来处理请求,对应的网站根目录是/var/www/example.com。 - 对于请求
example.org和www.example.org,Nginx 会使用第二个 server 块来处理请求。对应的网站根目录是/var/www/example.org。 - 对于其他请求,Nginx 会返回 404 错误。
server {
    listen 80;  # 监听的端口
    server_name example.com www.example.com;  # 指定的域名
    root /var/www/example.com;  # 网站根目录
    location / {
        try_files $uri $uri/ =404;
    }
}

server {
    listen 80;  # 监听的端口
    server_name example.org www.example.org;  # 指定的域名
    root /var/www/example.org;  # 网站根目录
    location / {
        try_files $uri $uri/ =404;
    }
}

server {
    listen 80 default_server;  # 默认站点
    server_name _;  # 默认域名
    return 404;
}
那 default_server 又是什么意思呢?它表示默认站点,当请求的域名不在 server_name 中时,Nginx 会使用 default_server 对应的 server 块来处理请求。该站点的 server_name 指定为 _,是一种约定俗成的默认域名,本身没有特殊含义。对于配置了 default_server 的 server 块,你也可以完全不写 server_name 指令。一般建议为 Nginx 配置一个默认站点,用于处理未知域名的请求。
!!! example "拒绝未知域名请求" {#reject-unknown-domain}
你也可以通过配置一个默认站点来拒绝未知域名的请求,例如:

```nginx
server {
    listen 80 default_server;  # 默认站点
    listen [::]:80 default_server;
    listen 443 default_server ssl;  # 默认站点(HTTPS)
    listen [::]:443 default_server ssl;
    ssl_reject_handshake on;  # 拒绝 SSL 握手
    return 444;  # 直接关闭连接
}
```

这样,当请求的域名不符合任何一个已经配置的 `server_name` 时,Nginx 对于 HTTP 请求会直接关闭连接,同时拒绝 HTTPS 请求的 SSL 握手。

一些特定地区或环境的监管要求 HTTP 服务器对未备案登记的域名的请求拒绝响应,这时可以使用这种配置。
我们建议将不同的站点配置放置于不同的文件中:
server {
    listen 80;
    server_name example.com www.example.com;
    # ...
}
server {
    listen 80;
    server_name example.org www.example.org;
    # ...
}
然后在 /etc/nginx/sites-enabled 目录下创建符号链接:
sudo ln -sf /etc/nginx/sites-available/example.com /etc/nginx/sites-enabled/
sudo ln -sf /etc/nginx/sites-available/example.org /etc/nginx/sites-enabled/
# 默认情况下 default 站点已经启用
# sudo ln -sf /etc/nginx/sites-available/default /etc/nginx/sites-enabled/
处理复杂的 location 匹配
在 location 块里,我们可以使用一些指令来处理请求,如:
proxy_pass http://backend_server;:反向代理。root /var/www/html;:指定网站根目录。try_files $uri $uri/ =404;:尝试查找文件,如果找不到返回 404 错误。return 200 "Hello, World!";:返回指定的状态码和内容。include fastcgi_params;:导入fastcgi_params文件的内容,引入 FastCGI 参数。
同时在一个 server 块中,我们也可以定义多个 location 块来处理不同的请求路径。以下介绍几种常见的 location 匹配方式。
Location 匹配
Nginx 需要决定由哪个 location 块来处理请求时,会根据请求的 URI path 来匹配 location 块。
Nginx 支持多种匹配方式,主要通过 location 指令后面的可选修饰符来区分。常用的修饰符有:
- 前缀匹配(无修饰符)
-
前缀匹配是最基本的匹配方式,只要请求的路径以
location块的路径开头,就会匹配成功。例如:多个前缀匹配时,Nginx 会选择匹配前缀最长的
location块。例如:在此例中,请求
/example、/example123和/example/test会匹配第一个location;请求/example/sub/page会匹配到第二个location,因为它的前缀更长。 - 前缀匹配(
^~) -
这是另一种形式的前缀匹配,匹配规则与无修饰符相同,但会阻止后续的正则匹配检查。
location ^~ /static/ {
    # 处理以 /static/ 开头的请求
    root /var/www/html/static;
}

location ~ \.css$ {
    # 处理以 .css 结尾的请求
    root /var/www/html/styles;
}
在这个例子中,如果请求的 URI 是
/static/style.css,则会匹配到第一个location块,因为它是以/static/开头的前缀匹配,且使用了^~,Nginx 不会继续检查正则匹配。 - 精确匹配(
=) -
精确匹配,只有请求的路径与
location块的路径完全相同时才匹配,优先级最高。 - 正则匹配(
~和~*) -
正则匹配的 modifier 有两种,区分大小写的
~与不区分大小写的~*。两种 modifier 的优先级都是最低的,例如:
Location 块的匹配顺序
Nginx 在处理请求时会按照以下顺序匹配 location 块:
- 精确匹配 (
=)。 -
前缀匹配(无修饰符和
^~,按最长前缀匹配)。在此步骤中,所有无修饰符和
^~的location块会一起参与匹配,Nginx 会选择匹配前缀最长的 location。 在确定了最长前缀匹配后,如果该location块使用了^~修饰符,Nginx 会停止匹配过程,直接使用该location块处理请求;否则,Nginx 会继续进行正则匹配检查。 -
正则匹配(
~和~*,按在配置文件中的出现顺序匹配)。如果有匹配到的正则表达式,Nginx 会使用该
location块处理请求。 如果没有匹配到的正则表达式,Nginx 会使用第二步中匹配到的前缀location块处理请求。
!!! question "分析以下配置的问题" {#location-matching-analysis}
以下配置节选自 [Hackergame 2020 题目「超简易的网盘服务器」](https://github.com/USTC-Hackergame/hackergame2020-writeups/tree/master/official/%E8%B6%85%E7%AE%80%E6%98%93%E7%9A%84%E7%BD%91%E7%9B%98%E6%9C%8D%E5%8A%A1%E5%99%A8),该服务为 [h5ai](https://github.com/lrsjng/h5ai)(一个 PHP 编写的文件分享服务):

```nginx
# 根目录是私有目录,使用 basic auth 进行认证,只有我自己可以访问
location / {
    auth_basic "easy h5ai. For visitors, please refer to public directory at `/Public!`";
    auth_basic_user_file /etc/nginx/conf.d/htpasswd;
}

# Public 目录是公开的,任何人都可以访问,便于我给大家分享文件
location /Public {
    allow all;
    index /Public/_h5ai/public/index.php;
}

# PHP 的 fastcgi 配置,将请求转发给 php-fpm
location ~ \.php$ {
    fastcgi_pass   127.0.0.1:9000;
    fastcgi_index  index.php;
    fastcgi_param  SCRIPT_FILENAME  $document_root$fastcgi_script_name;
    include        fastcgi_params;
}
```

根据以上 location 匹配顺序的介绍,分析该配置存在什么**安全**问题?
TLS
TLS 是一种加密通信协议,用于保护客户端和服务器之间的通信安全。HTTPS 就使用了 TLS。你可以在 https://cherr.cc/ssl.html 找到 SSL/TLS 的原理解释。
!!! note "SSL?" {#ssl-vs-tls}
在早期,HTTPS 使用 SSL 来加密通信,但是人们后续发现 SSL 存在一些安全漏洞,因此逐渐被 TLS 取代。尽管如此,SSL 这个术语仍然被广泛使用,尤其是在非正式场合下。因此,SSL 和 TLS 在很多情况下可以视为同义词。
一般的 HTTP 监听端口是 80,HTTPS 监听端口是 443,这是 IANA(互联网号码分配局)为这两种协议分配的标准端口号。Nginx 支持 TLS 协议,可以用来配置 HTTPS 站点。
申请证书
首先,你需要为你的域名申请一个 TLS 证书。一般有以下几种方式:
- 使用基于 ACME 协议的免费证书,例如 Let's Encrypt、ZeroSSL 等。可以使用 Certbot、acme.sh、lego 等工具来申请和自动续期证书。
- 购买商业证书。
- 自签名证书(仅用于测试环境,不建议在生产环境中使用)。
!!! tip "ngx_http_acme_module" {#ngx-http-acme-module}
Nginx 的 [`ngx_http_acme_module`](https://nginx.org/en/docs/http/ngx_http_acme_module.html) 也实现了 ACME 协议,可以类似 Caddy 那样避免多余的证书管理工具,直接让 Nginx 自行申请和续期证书。该模块可能需要自行编译安装。
!!! comment "@taoky: 商业证书一定比免费证书更好吗?" {#commercial-vs-free-certificates}
不一定。经常有的一种论调是:商业证书因为付了钱,所以比 Let's Encrypt 等免费证书更可靠、更安全,例如像[下面这样](https://www.bilibili.com/opus/1119462279183597571):

> 北大用的商业证书,这种证书能证明这个网站确实属于北京大学,你可以看证书颁发对象的组织栏。清华用的是免费证书(注:Let's Encrypt),没有组织信息,不能证明这个网站属于清华大学。商业证书大概每年万把块?我不清楚具体行情,但世一大不应该差这点钱[吃瓜]

这里存在的几个常见的误解是:

1. 「商业证书」不代表一定有组织信息。证书分为三种:DV(Domain Validation,域名验证)、OV(Organization Validation,组织验证)和 EV(Extended Validation,扩展验证)。其中 DV 证书只验证域名所有权。以上提供免费证书的服务只签署 DV 证书,而付费 CA 除了 OV 和 EV 证书以外,也大量销售 DV 证书。
2. 证书的核心功能是:证明你连接的是域名对应的服务器,并且加密传输的数据。不管是 DV、OV 还是 EV 证书,都能同等安全地实现这个功能。
3. 在很久以前,浏览器会给 EV 证书在地址栏显示组织信息,但是现代浏览器早已经不再这么做了。因为:

    - 大部分人不怎么看地址栏,更别说注意到组织信息了。
    - 用户大多只关注是不是 HTTPS(在很久以前,如果网站是 HTTPS 的话,地址栏左侧对应区域会是绿的),而不会刻意去区分证书类型。
    - 恶意攻击者可以合法注册一个名称相似的组织,然后申请 EV 证书用于诈骗,这样的 EV 证书可能反而会强化用户的错误信任。例如 [2017 年曾有安全研究员注册了名叫「Identity Verified」(身份已验证)的公司,并申请到了 EV 证书](https://www.bleepingcomputer.com/news/security/extended-validation-ev-certificates-abused-to-create-insanely-believable-phishing-sites/), [同年另一名安全研究员用不到 200 美元成功注册了一个名为「Stripe, Inc.」的组织,并给自己的域名申请到了对应的 EV 证书,用于展示 EV 证书的设计缺陷](https://arstechnica.com/information-technology/2017/12/nope-this-isnt-the-https-validated-stripe-website-you-think-it-is/)。

    因此,即使申请 EV 证书,这种付费 CA 的「背书」意义也非常有限。至少除非你不怕麻烦,而且钱多得没地方花,否则我个人并不建议为了 EV 证书而花钱。
4. 免费证书使用的 ACME 协议决定了,能为域名申请到有效证书的前提是申请方对域名有控制权。并且,现在所有证书签署都有证书透明度(Certificate Transparency,CT)机制,任何人都可以[查询](https://crt.sh/)到某个域名对应的证书签署记录。因此想要骗签证书难度很大,并且很容易被发现。
5. 安全性不取决于花了多少钱,而是取决于具体实践。ACME 协议支持自动化签署、续期证书,可以大大降低人为操作失误(包括泄漏私钥、忘记续期)的风险。而**如果花了钱买了 EV 证书,但是最后部署的时候却是通过微信(我听说过不止一例类似的情况)给对应服务的运维传递证书私钥,那安全性反而大大降低了,远不如自动化的免费证书**。
!!! tip "Debian 的 snakeoil 自签名证书" {#debian-snakeoil-certificate}
Debian 系统的 `ssl-cert` 包自带了一个自签名的测试证书。对应的证书在 `/etc/ssl/certs/ssl-cert-snakeoil.pem`,私钥在 `/etc/ssl/private/ssl-cert-snakeoil.key`。可以用它本地测试 HTTPS 配置,但不建议在生产环境中使用。

如果需要重新生成,可以执行:

```bash
make-ssl-cert generate-default-snakeoil -f
```
!!! tip "使用 mkcert 等程序创建 CA 证书" {#use-mkcert}
以上介绍的「蛇油证书」对简单的场景够用了,但是在一些场景下我们需要生成 CA 证书,再使用 CA 证书签署新的证书(例如需要配置让程序信任使用指定 CA 证书签发的证书)。OpenSSL 虽然能解决这个问题,但是实在是太麻烦了——
??? note "如果 OpenSSL 是 GUI 程序,会是什么样子的?" {#openssl-gui}
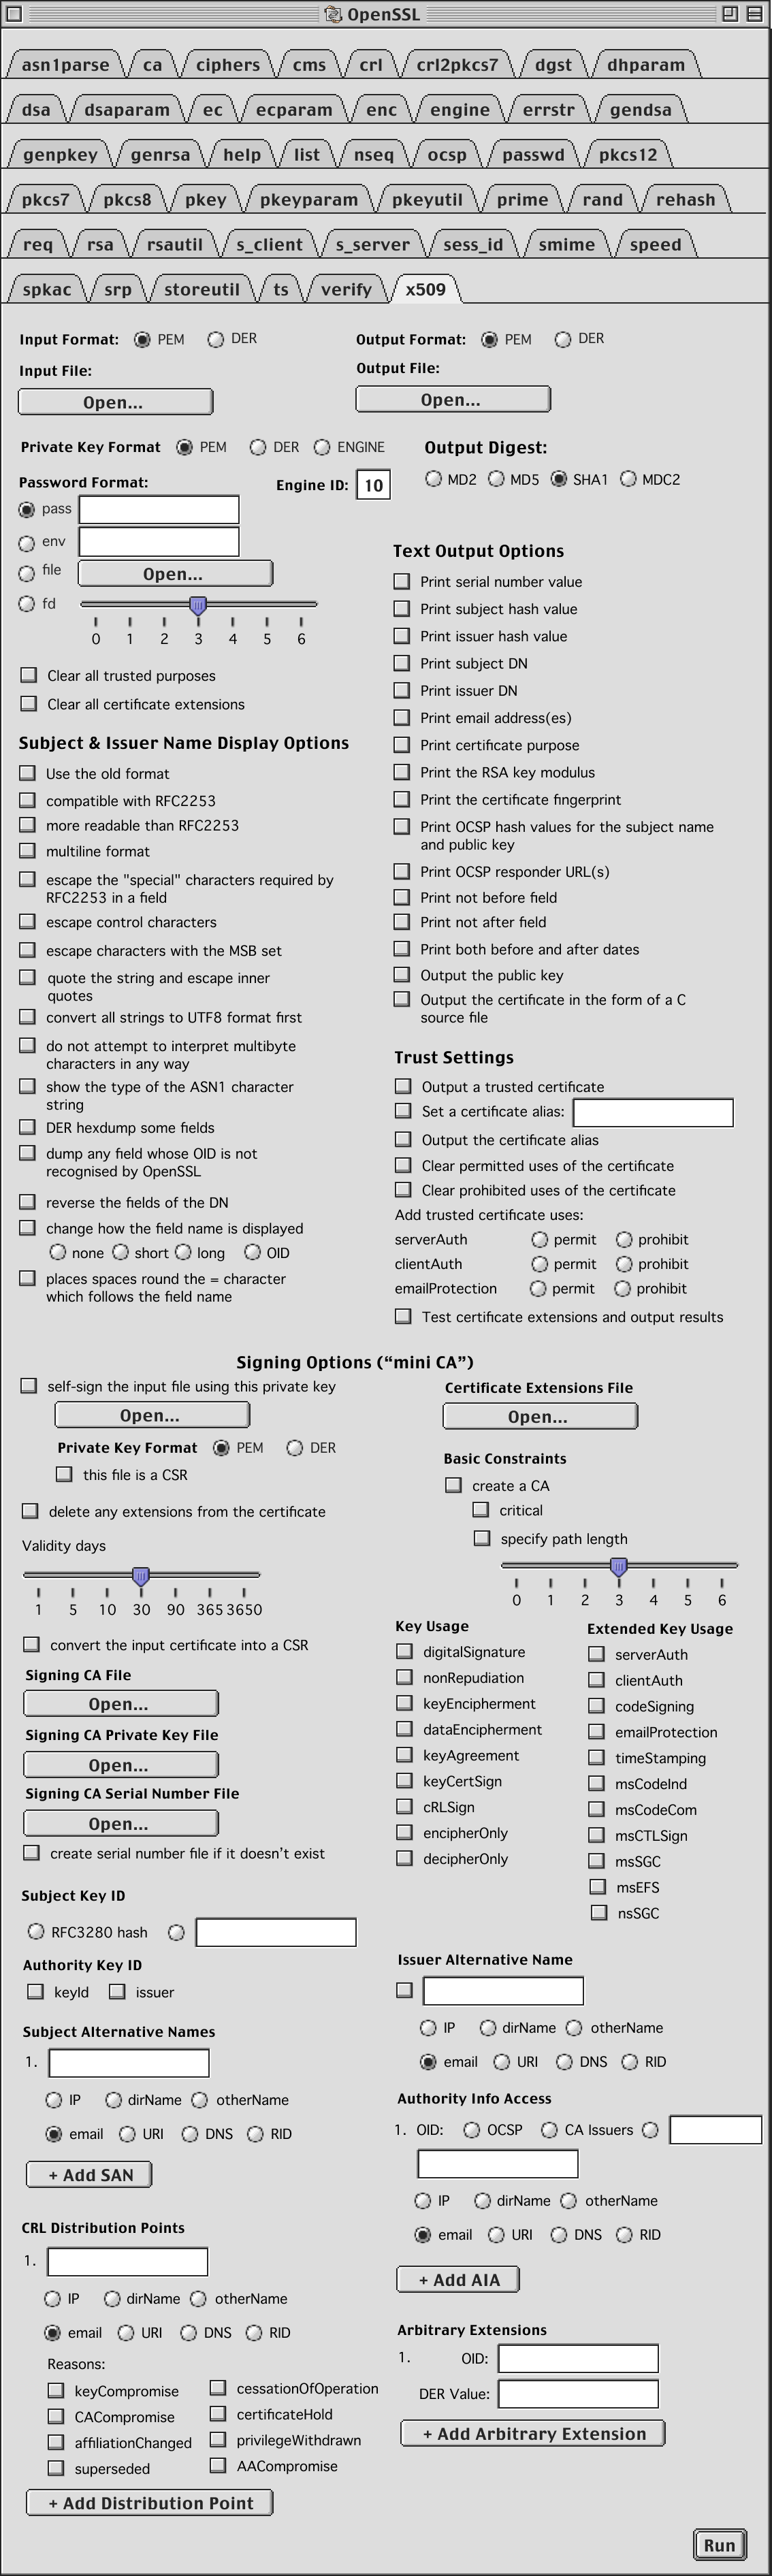
/// caption
图片来自 [If OpenSSL were a GUI](https://smallstep.com/blog/if-openssl-were-a-gui/)
///
如果是测试 HTTPS 网站,推荐使用 [mkcert](https://github.com/FiloSottile/mkcert) 用于快速测试。安装 `mkcert` 包后可以直接让它生成指定域名的证书,它会自动生成对应的 CA 证书:
```console
$ mkcert example.com
Created a new local CA 💥
Note: the local CA is not installed in the system trust store.
Run "mkcert -install" for certificates to be trusted automatically ⚠️
Created a new certificate valid for the following names 📜
- "example.com"
The certificate is at "./example.com.pem" and the key at "./example.com-key.pem" ✅
It will expire on 5 July 2028 🗓
```
CA 证书存储的位置可以使用 `mkcert -CAROOT` 查看。
??? note "我还是想用 OpenSSL" {#i-want-to-use-openssl}
```shell
# 创建 CA 证书与密钥
openssl genrsa -out ca.key 4096
openssl req -x509 -new -noenc -key ca.key -sha256 -days 3650 -subj "/CN=ExampleCA" -out ca.crt
# 创建需要签名的证书密钥与证书签名请求(CSR)
# 此处额外添加了需要向证书添加的扩展信息(以 SAN——Subject Alt Name 为例)
openssl genrsa -out cert.key 4096
openssl req -new -key cert.key -subj "/CN=example.com" -out cert.csr \
-addext "subjectAltName=DNS:example.com,DNS:*.example.com,IP:127.0.0.1"
# 进行签名,生成证书
openssl x509 -req -in cert.csr -CA ca.crt -CAkey ca.key -CAcreateserial -out cert.crt -days 825 -sha256 -copy_extensions copy
# 验证
openssl verify -CAfile ca.crt cert.crt
```
如果需要更完整的 CA 管理(支持非 HTTPS 场景、客户端证书、证书吊销等),则可以使用由 OpenVPN 项目维护的 [easy-rsa](https://github.com/OpenVPN/easy-rsa) 工具:
```sh
# 创建 PKI 与 CA
/usr/share/easy-rsa/easyrsa init-pki
/usr/share/easy-rsa/easyrsa build-ca
# 创建服务端证书(不加密)
/usr/share/easy-rsa/easyrsa build-server-full server1 nopass
# 创建客户端证书(不加密)
/usr/share/easy-rsa/easyrsa build-client-full client1 nopass
/usr/share/easy-rsa/easyrsa build-client-full client2 nopass
# 吊销 client2 的证书,生成包含吊销信息的 CRL(Certificate Revocation List)
/usr/share/easy-rsa/easyrsa revoke client2
/usr/share/easy-rsa/easyrsa gen-crl
```
??? note "为什么要区分服务端证书和客户端证书?" {#server-client-cert-difference}
两者的区别在于它们的扩展信息:
```conf title="/usr/share/easy-rsa/x509-types/server"
# X509 extensions for a server
basicConstraints = CA:FALSE
subjectKeyIdentifier = hash
authorityKeyIdentifier = keyid,issuer:always
extendedKeyUsage = serverAuth
keyUsage = digitalSignature,keyEncipherment
```
```conf title="/usr/share/easy-rsa/x509-types/client"
# X509 extensions for a client
basicConstraints = CA:FALSE
subjectKeyIdentifier = hash
authorityKeyIdentifier = keyid,issuer:always
extendedKeyUsage = clientAuth
keyUsage = digitalSignature
```
区分两者是因为安全原因,特别是对网页浏览以外的用途:设想这样一种情况,Eve 拿到了自己由某 CA 签发的客户端证书。如果不做功能区分,Eve 就可能可以使用自己的客户端证书进行中间人攻击,此时被攻击的用户发现服务器上 Eve 的证书确实是 CA 签发的,一些应用程序此时就会信任 Eve 中间人,导致安全问题。
另外,[xca](https://www.hohnstaedt.de/xca/) 是一个 GUI 的证书管理程序,相比于命令行工具更容易上手。
以下假设你的证书保存在 /etc/nginx/ssl/example.com.crt 和 /etc/nginx/ssl/example.com.key。
!!! tip "证书格式" {#certificate-format}
PEM 格式是最常见的证书格式。其内容为纯文本,包含 base64 编码的相关数据。对于证书(一般为 `pem`、`crt` 或者 `cer` 后缀):

```pem
-----BEGIN CERTIFICATE-----
(base64 编码的数据)
-----END CERTIFICATE-----
```

对于私钥(一般为 `pem` 或 `key` 后缀):

```pem
-----BEGIN PRIVATE KEY-----
(base64 编码的数据)
-----END PRIVATE KEY-----
```

可以使用 OpenSSL 工具查看信息:

```bash
openssl x509 -in example.crt -text -noout  # 查看证书信息
openssl pkey -in example.key -text -noout  # 检查私钥
```
!!! tip "fullchain.pem" {#fullchain-pem}
一些 ACME 客户端会生成 `fullchain.pem` 文件,它包含了服务器证书和中间证书的完整链。如果存在这个文件,请**优先使用**它,否则浏览器以外的其他客户端可能会因为缺少中间证书而无法验证证书链。
TLS 配置
然后,你需要在 Nginx 配置文件中添加 TLS 配置:
server {
    listen 443 ssl;  # 监听的端口
    server_name example.com;  # 指定的域名
    root /var/www/example.com;  # 网站根目录

    ssl_certificate /etc/nginx/ssl/example.com.crt;  # TLS 证书路径
    ssl_certificate_key /etc/nginx/ssl/example.com.key;  # TLS 证书密钥路径

    # (可选)SSL 设置
    ssl_protocols TLSv1.2 TLSv1.3;  # 启用的 TLS 协议(默认值)
    ssl_ciphers 'HIGH:!aNULL:!MD5';  # 使用的加密套件(默认值)
    ssl_prefer_server_ciphers on;  # 优先使用服务器的加密套件(默认为 off)
    ssl_session_cache shared:SSL:10m;  # TLS 会话缓存大小(默认没有缓存)
    ssl_session_timeout 10m;  # TLS 会话超时时间(默认为 5m)

    # (可选)HSTS(HTTP Strict Transport Security)
    add_header Strict-Transport-Security "max-age=31536000; includeSubDomains" always;

    location / {
        try_files $uri $uri/ =404;
    }
}
注意到和前文的配置不同,这里的监听端口是 443,而且增加了 ssl 选项。ssl_certificate 和 ssl_certificate_key 分别指定了 TLS 证书和密钥的路径。
!!! note "既然 TLS 是加密的,那么 Nginx 是怎么在握手阶段知道要用哪个 server 块,以及里面对应的证书呢?" {#tls-sni-server-selection}
在 TLS 握手阶段,绝大多数客户端都会发送 SNI(Server Name Indication,服务器名称指示)信息,告诉服务器它想要连接的域名。**SNI 是明文的**,因此服务器可以根据 SNI 信息来选择对应的 `server` 块和证书。
!!! tip "使用 curl 调试指定 IP 地址上的 HTTPS 站点" {#curl-resolve-https-debugging}
假设你希望 `curl` 能够命中某个服务器(以 127.0.0.1 为例子)上的 example.com `server` 块,但是 example.com 的 DNS 解析不指向这个服务器。对 HTTP 网站可以直接这么做:

```shell
curl -H "Host: example.com" http://127.0.0.1
```

但是对 HTTPS 网站是不行的,因为 nginx 会先使用 SNI 匹配,而 `https://127.0.0.1` 会导致 SNI 为 127.0.0.1,无法匹配到 example.com。解决方法为:

```shell
curl --resolve example.com:443:127.0.0.1 https://example.com
```
在配置文件中,我们还提到了一些可选的配置,如中间证书、TLS 设置、HSTS 等。一般建议设置 ssl_protocols TLSv1.2 TLSv1.3;,因为 SSLv3、TLSv1.0 和 TLSv1.1 等旧的加密协议已经不再被认为是安全的了。
!!! note "ssl_dhparam" {#ssl-dhparam}
由于非对称加密的性能不及对称加密,因此 TLS 在握手阶段需要非对称交换对称加密的密钥。在最早期的时候,SSL 使用 RSA 算法进行密钥交换——客户端生成对称加密密钥,使用服务端证书的公钥加密之后,服务端用自己的私钥解密。但是一旦私钥泄露,那么以往的加密流量也就能够轻松解密出来。而使用 Diffie-Hellman 算法的 DHE(Ephemeral DH)会在每次都生成新的 DH 私钥(算法的具体细节这里不展开),即使未来私钥泄露,以往的流量也无法轻松解密。这种性质也被称为**前向安全性(forward secrecy)**。

DHE 需要 DH 参数,早期 Nginx 等服务都会自带一个固定的 DH 参数,但是后来证明这样会[削弱安全性](https://weakdh.org/),因此 Nginx 目前 [`ssl_dhparam`](https://nginx.org/en/docs/http/ngx_http_ssl_module.html#ssl_dhparam) 参数默认为空。不过目前,DHE 因为性能问题已经被弃用,和 RSA 密钥交换一起在 TLS 1.3 中被移除。目前 TLS 的主流密钥交换为基于椭圆曲线算法的 ECDHE,因此这一项参数也可以不用再设置了。
HSTS 是一种安全机制,用于强制客户端(浏览器)使用 HTTPS 访问网站。当用户首次访问支持 HSTS 的网站时,浏览器会通过 HTTP 或 HTTPS 发送请求。如果网站支持 HSTS,服务器会在响应中包含 Strict-Transport-Security 头部,指示浏览器该网站应仅通过 HTTPS 访问。add_header Strict-Transport-Security "max-age=31536000; includeSubDomains" always; 表示启用 HSTS,浏览器会在 1 年内强制使用 HTTPS 访问网站,并且包括子域名。
!!! tip "购买域名之前注意一下 HSTS 预加载列表哦!" {#check-hsts-preload-before-domain}
[HSTS 预加载列表(HSTS Preload List)](https://hstspreload.org)是一个由浏览器维护的列表,在这个列表里面的网站浏览器在访问时必须使用 HTTPS。如果买了一个在 HSTS 预加载列表上面的域名,但是不想用 HTTPS 的话,事情就会非常麻烦。

此外,一些 TLD(顶级域)也被加入到了 HSTS 预加载列表中,例如 `.dev` 等。
!!! lab "访问 HTTP 自动跳转到 HTTPS 的配置" {#http-to-https-redirect}
假设希望让用户访问 `http://example.com` 时自动跳转到 `https://example.com`,对应的 `server` 块要怎么写呢?(提示:`return` 指令;HTTP 301 是永久重定向)
反向代理与负载均衡
在站点配置简介部分,我们给出了一个简单的反向代理配置示例。实际上,Nginx 的反向代理功能非常强大,可以实现负载均衡、缓存、请求修改等功能。
反向代理杂项配置
以下介绍一些常用的反向代理配置选项:
location / {
    proxy_pass http://backend_server;  # 反向代理的地址
    # 设置 header 部分略过
    proxy_buffering on;  # 启用 buffering(默认启用)
    proxy_ssl_server_name on;  # 向后端服务器发送 SNI(默认关闭)
    proxy_connect_timeout 10s;  # 连接后端服务器的超时时间(默认 60s)
    proxy_max_temp_file_size 128m;  # 临时文件的最大大小(默认 1024m)
}
这里比较重要的配置是 buffering 的启用与否。在启用 buffering 的时候,Nginx 在收到后端数据后,不会立刻给客户端,而是先将数据缓存在内存或者临时文件中,然后再发送,以此提高吞吐量。但是对于延迟敏感的应用,或者在磁盘空间有限的情况下,可能需要关闭 buffering。
在以上的配置中,因为 proxy_pass 的地址中不包含任何路径(即域名/IP 之后没有 /),Nginx 会将用户请求的 URI($request_uri)原样转发给后端服务器(如果额外添加了 rewrite 规则,则是修改后的 $uri)。但是有些时候,我们会希望后端服务器只处理某个路径下的请求,例如当用户请求 /api/foo 时,后端服务器看到的是 /foo。这时可以在 proxy_pass 的地址后面添加一个 /,例如:
于是,当用户请求 /api/foo 时,/api/ 会被替换为 /,后端服务器实际收到的请求路径是 /foo。
此外,在配置一些应用的时候,可能需要额外添加 WebSocket 支持。
!!! note "WebSocket 是什么?" {#what-is-websocket}
在现代网站开发时,经常存在的一种需求是:服务端需要主动向客户端推送数据,而不是仅仅被动地响应客户端(浏览器)请求。如果让浏览器定期轮询服务器,既浪费资源,又增加延迟。WebSocket 协议正是为了解决这个问题而设计的。它允许在客户端和服务器之间建立一个持久的双向通信通道,从而实现实时数据传输。

WebSocket 协议在协商时会先发送一个 HTTP/1.1 请求,包含 `Upgrade: websocket` 与 `Connection: Upgrade` 头,表示请求升级到 WebSocket 协议。
Nginx 提供了相关配置的文档。以下也给出一个示例:
http {
    # ...
    map $http_upgrade $connection_upgrade {
        default upgrade;
        ''      close;
    }

    server {
        # ...

        location / {
            # 其他反向代理配置略过
            proxy_http_version 1.1;  # 使用 HTTP/1.1 协议
            proxy_set_header Upgrade $http_upgrade;  # 支持 WebSocket 升级
            proxy_set_header Connection $connection_upgrade;  # 支持 WebSocket 连接
        }
    }
}
!!! tip "以 $http_ 开头的变量" {#http-variables}
Nginx 会自动将所有 HTTP 请求头转换为以 `$http_` 开头的变量,变量名中的连字符 `-` 会被替换为下划线 `_`。例如,HTTP 请求头 `Upgrade` 对应的变量是 `$http_upgrade`,`User-Agent` 对应的变量是 `$http_user_agent`。
这里 map 指令必须在 http 块中,定义了一个从 HTTP 请求的 Upgrade 头到 $connection_upgrade 变量的映射关系。
!!! note "为什么不能 proxy_set_header Connection $http_connection?" {#proxy-connection-header}
在 HTTP 标准中,[`Connection`](https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Headers/Connection) 头是 hop-by-hop 的,这意味着这个头[不应该按照原样转发](https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Headers#hop-by-hop_headers)。直接转发会存在非预期的副作用。
!!! tip "替换响应中的字符串" {#replace-response-string}
有些时候我们会不得不需要修改上游返回的内容,特别是在没有办法修改上游(一般是网站后端)代码和配置的时候。例如,上游可能在返回的 HTML 里面写死了路径 `/static/`,但是你希望放在 `/app/static/`。此时可以使用 [`ngx_http_sub_module`](https://nginx.org/en/docs/http/ngx_http_sub_module.html) 模块提供的 [`sub_filter`](https://nginx.org/en/docs/http/ngx_http_sub_module.html#sub_filter) 相关的指令:

```nginx
location /app {
    # 省略其他设置
    sub_filter '/static/' '/app/static/';
    sub_filter_once off;  # 全部替换,而不是只换一次
    sub_filter_last_modified on;  # 不清除 Last-Modified 头
    sub_filter_types *;  # 默认只替换 HTML 中的内容。* 扩展到了所有类型的响应
}
```
反代缓存
Nginx 可以作为反向代理缓存服务器,缓存后端的响应内容,从而减少后端的负载,提升性能。常用于缓存局域网外部的静态资源(将外部的网站作为反向代理的「后端」),提供给局域网内的用户访问。
首先需要在 http 块中设置缓存路径,类似如下:
http {
    # ...
    proxy_cache_path /var/cache/nginx levels=1:2 keys_zone=exampleCache:128m inactive=1d max_size=4G;
}
这里,proxy_cache_path 指令定义了缓存存储路径等参数。这里的参数含义如下:
levels=1:2:定义缓存目录的层级结构,1:2表示第一层目录使用 1 个字符,第二层目录使用 2 个字符,最终路径就类似于/var/cache/nginx/a/bc/...bca这样的形式。这是为了避免单个目录下文件过多在一些文件系统中会导致的性能问题。keys_zone=exampleCache:128m:定义缓存键值区域的名称和大小,这里是exampleCache,大小为 128MB。注意 128MB 不是缓存的总大小,而只是用于存储缓存键值的内存大小。1MB 大约可以存储 8000 个键。inactive=1d:定义缓存项在多长时间内没有被访问就会被删除,这里是 1 天。默认是 10 分钟。max_size=4G:定义缓存的最大大小,这里是 4GB。
之后在需要缓存的块中加入 proxy_cache 指令。以下是一个比较激进的缓存配置:
location / {
    proxy_pass http://backend_server;
    proxy_cache exampleCache;  # 启用 exampleCache 对应的缓存
    proxy_cache_valid 200 12h;  # 定义 200 响应的缓存时间为 12 小时
    proxy_cache_valid 301 302 6h;  # 定义 301 和 302 响应的缓存时间为 6 小时
    proxy_cache_valid 400 500 502 504 1m;  # 定义 4xx 和 5xx 响应的缓存时间为 1 分钟
    proxy_cache_valid any 5m;  # 定义其他响应的缓存时间为 5 分钟
    proxy_cache_revalidate on;  # 对过期的缓存使用条件请求
    proxy_cache_use_stale error timeout invalid_header updating http_500 http_502 http_503 http_504;  # 在后端错误时使用过期缓存
    add_header X-Cache-Status $upstream_cache_status;  # 添加响应头显示缓存状态
}
这里加入的一些额外选项:
proxy_cache_valid指令用于定义不同响应状态码的缓存时间。proxy_cache_revalidate则会在缓存过期后使用条件请求(If-Modified-Since 或 If-None-Match)来验证缓存的有效性,如果后端资源没有变化,则继续使用缓存。proxy_cache_use_stale指令允许在后端服务器出现错误时使用过期的缓存响应,从而提高可用性。- 最后的
add_header用于在响应头中添加一个X-Cache-Status字段,显示缓存状态(HIT、MISS、BYPASS等)。
负载均衡配置
负载均衡是 Nginx 的另一个重要功能,可以用于分发请求到多个后端服务器,提高性能和可靠性。
一个典型的负载均衡配置如下:
http {
    upstream backend {
        server backend1.example.com;
        server backend2.example.com;
        server backend3.example.com;
    }

    server {
        listen 80;
        server_name example.com;

        location / {
            proxy_pass http://backend;  # 将请求转发到 upstream 定义的后端服务器
            proxy_set_header Host $host;
            proxy_set_header X-Real-IP $remote_addr;
            proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        }
    }

    server {
        listen 80;
        server_name another-example.com;

        location / {
            proxy_pass http://backend;  # 也可以使用相同的 upstream
            proxy_set_header Host $host;
            proxy_set_header X-Real-IP $remote_addr;
            proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        }
    }
}
Nginx 支持多种负载均衡算法,如轮询、加权轮询、IP 哈希、最少连接等。
Nginx 支持多种负载均衡算法,默认是轮询(round-robin)。可以通过在 upstream 块中指定不同的算法来更改负载均衡策略,例如:
加权轮询:
upstream backend {
    server backend1.example.com weight=3;  # 权重为 3
    server backend2.example.com weight=1;  # 权重为 1
}
最少连接:
upstream backend {
    least_conn;  # 使用最少连接算法
    server backend1.example.com;
    server backend2.example.com;
}
IP 哈希,使得同 IP 的用户始终可以访问到同一个节点:
upstream backend {
    ip_hash;  # 使用 IP 哈希算法
    server backend1.example.com;
    server backend2.example.com;
}
根据 key 指定的变量进行哈希:
upstream backend {
    hash $request_uri consistent;  # 使用请求 URI 进行哈希
    server backend1.example.com;
    server backend2.example.com;
}
!!! tip "一致性哈希算法" {#consistent-hashing}
在上面的配置中,我们添加了 `consistent` 选项,这表示使用[一致性哈希算法](https://en.wikipedia.org/wiki/Consistent_hashing),而不是传统的 `hash(key) % N` 的方法。它可以保证在节点数量变化时,尽可能少地改变已有的映射关系。
server 块后还可以添加诸如 max_fails(最大失败次数)、fail_timeout(失败超时时间)等参数来控制节点的故障转移行为。
文件列表
Nginx 自带的 ngx_http_autoindex_module 与非常流行的 ngx_http_fancyindex_module 模块都可以用于生成目录列表页面,方便用户浏览和下载文件。
最简单的方式就是使用 autoindex on; 指令,例如:
如果 autoindex 设置为 off,并且 index 指令中没有匹配的文件,Nginx 会返回 HTTP 403。
!!! tip "autoindex 的 JSON 输出支持" {#autoindex-json-output}
`autoindex` 的 HTML 的输出很简陋。不过鲜为人知的是,`autoindex` 也支持输出为 XML、JSON 或 JSONP 格式。JSON 类格式可以方便前端的 JavaScript 进行处理,从而实现更复杂、美观的文件列表界面。对应的指令为 [`autoindex_format`](https://nginx.org/en/docs/http/ngx_http_autoindex_module.html#autoindex_format)。

生成的 JSON 类似如下:

```json
[
{ "name":"example_dir", "type":"directory", "mtime":"Wed, 12 Nov 2025 16:28:30 GMT" },
{ "name":"example", "type":"file", "mtime":"Wed, 12 Nov 2025 16:28:26 GMT", "size":0 }
]
```

??? tip "JSONP" {#jsonp}

    JSONP(JSON with Padding)是一种古老的在前端获取其他站点数据(跨域)的技术。在以上的例子中,如果 `autoindex_format` 设置为 `jsonp`,则在请求时添加 `callback` 参数即可获得 JSONP 格式的响应,例如 `http://example.com/files/?callback=handleFileList`:

    ```javascript
    /* callback */
    handleFileList([
    { "name":"example_dir", "type":"directory", "mtime":"Wed, 12 Nov 2025 16:28:30 GMT" },
    { "name":"example", "type":"file", "mtime":"Wed, 12 Nov 2025 16:28:26 GMT", "size":0 }
    ]);
    ```

    JSONP 设计是需要在 `<script>` 标签中引用:

    ```html
    <script src="http://example.com/files/?callback=handleFileList"></script>
    ```

    由于浏览器不会限制在 `<script>` 标签中使用其他站点的脚本,因此通过 JSONP 协议可以实现跨域数据获取。但是,这种技术存在严重的安全风险(需要执行不受信任的第三方代码),因此已经过时了。目前主流的方式是通过 CORS(跨域资源共享)来实现跨域请求。
如果需要更好看的界面,一般会使用 fancyindex 模块(libnginx-mod-http-fancyindex 包)。添加 fancyindex on; 指令后,fancyindex 就会以默认样式生成文件列表页面。用户可以自定义 CSS、header 和 footer 来美化页面,网络上也有不少现成的样式可以参考。
!!! note "使用一个专门的后端程序生成文件列表页面" {#backend-generated-file-listing}
你可能会希望使用其他的文件列表程序(例如 [h5ai](https://github.com/lrsjng/h5ai),或者我们编写的用于科大镜像站的 [yadex](https://github.com/ustclug/yadex)),同时在用户访问文件时让 Nginx 直接提供,而不是让后端程序处理文件下载请求。以下是一个参考配置,视具体的文件列表程序,可能需要做一些调整:

```nginx
root /var/www/files/;
autoindex off;
index index.html index.htm;

try_files $uri $uri/index.html $uri/index.htm @dir_check;

location @dir_check {
    internal;
    if (-d $request_filename) {  # 判断目录是否存在
        rewrite ^(.*)$ /_dir_handler/$1/ last;
    }
    return 404;
}

location /_dir_handler/ {
    internal;
    proxy_pass http://127.0.0.1:1234/;  # 文件列表程序监听的地址
}
```

不过 `try_files` 的问题是:它没有办法继承到子 `location` 中,这在配置复杂的情况下是难以接受的。因此我们可以有另一个 workaround 方案:`index` 指令的最后一个参数可以是 URI 绝对路径,例如 `index index.html /_dir_handler`。于是我们的配置可以改成:

```nginx
index index.html index.htm /_dir_handler;

location = /_dir_handler {
    internal;
    # 由于 $uri 已经是 /_dir_handler/,因此只能从 $request_uri 中获取原始请求路径
    proxy_pass http://127.0.0.1:1234/$request_uri;  # 文件列表程序监听的地址
}
```

有关 `internal` 与 `if` 等相关的介绍,可参考下文的 [Rewrite](#rewrite) 部分。
速率、请求与连接数限制
Nginx 提供了多种不同维度的限制功能,帮助减轻恶意流量对服务的影响,保护后端稳定运行,将更多资源分配给正常用户。以下介绍 Nginx 自带的限制功能,如果需要更复杂的规则,可以参考 Lua 部分。
速率限制
limit_rate 指令可以限制每个请求的速率。例如:
!!! tip "Nginx 使用的单位" {#nginx-unit-usage}
在 Nginx 配置中,`k`、`m`、`g` 均使用 1024 作为基数,而不是 1000。即分别是 KiB(Kibibyte)、MiB(Mebibyte)、GiB(Gibibyte)等。
如果希望做到类似「下载 2M 后限速到 10KB/s」(当然实际没有部署过这种配置)的效果,可以使用 limit_rate_after 指令:
但是,由于 limit_rate 只限制单个请求的速率,因此如果用户开启多个并发连接下载,实际的总速率会超过限制,因此还需要配合下面介绍的请求与连接数限制机制。
请求限制
ngx_http_limit_req_module 模块可以限制单位时间内的请求数量。和反代缓存有些类似的是,我们需要先使用 limit_req_zone 定义一个共享内存区域来存储请求计数器:
这里定义了一个名字为 global 的区域,大小为 10MB。在使用 $binary_remote_addr 作为 key 的情况下,一个 IPv4 地址为 4 字节,IPv6 地址为 16 字节,每个 IP 的状态需要 128 字节(64 位系统)。这个 zone 限制为每秒 20 个请求(20r/s)。
在需要限制请求的地方使用 limit_req 指令:
limit_req 使用漏桶(leaky bucket)算法来限制请求速率,想象一个底部有个洞的水桶,这个水桶的大小是 burst,从底部的洞流出来的水速率是 rate,外部的请求就是往水桶里倒水。如果水桶满了,那么新的请求就会被拒绝(nodelay)或者延迟(delay=0,默认行为)。
连接数限制
ngx_http_limit_conn_module 模块可以限制并发连接数。同样,使用 limit_conn_zone 定义一个共享内存区域:
之后使用 limit_conn 指令限制连接数:
Rewrite
Nginx 的 ngx_http_rewrite_module 模块提供了强大的 URI 改写(rewrite)、重定向(return)、变量设置(set)和条件判断(if)功能。与其他配置不同的是,rewrite 模块的指令是命令式(imperative)的,而不是声明式(declarative)的。这意味着 rewrite 模块的指令实际的效果依赖于其在配置中出现的顺序。模块文档给出的执行顺序是:
- 首先,
server块中的 rewrite 模块指令会按顺序执行。 - 匹配到
location块后,location块中的 rewrite 模块指令会按顺序执行。如果 URI 被改写,Nginx 会重新进行location匹配,但是这样的过程最多不会超过 10 次。
URI 改写与重定向
rewrite 指令可以根据正则表达式规则改写请求的 URI。以下展示一些实际的例子:
rewrite ^/nvidia-container-runtime(/.*)$ /libnvidia-container$1 last;
rewrite ^/pypi/(.*)$ /pypi/web/$1 break;
rewrite ^/flathub/(.*)$ $scheme://dl.flathub.org/repo/$1 redirect;
rewrite ^/fedora/linux/(.*?)$ /fedora/$1 permanent;
可以看到,rewrite 指令的第一个参数是一个正则表达式,用于匹配请求的 URI。第二个参数是改写后的 URI,可以使用正则表达式中的捕获组(例如 $1、$2 等,也支持 (?<name>pattern) 格式的 PCRE 命名捕获组)来引用匹配到的内容。第三个参数是可选的 flag:
last:不再执行当前块中后续 rewrite 模块的指令,并重新进行location匹配。break:不再执行当前块中后续 rewrite 模块的指令,但不会重新进行location匹配。redirect:返回 HTTP 302 临时重定向响应。permanent:返回 HTTP 301 永久重定向响应。
不过很多时候,我们不需要使用 rewrite 那么复杂的功能,直接使用 return 指令就可以了。例如:
!!! tip "internal 与 named location" {#internal-and-named-locations}
有时候我们希望某个路径只能在诸如 `rewrite`、[`error_page`](https://nginx.org/en/docs/http/ngx_http_core_module.html#error_page) 或 [`try_files`](https://nginx.org/en/docs/http/ngx_http_core_module.html#try_files) 等指令中被跳转访问,而不能被外部直接请求,此时可以使用 [`internal`](https://nginx.org/en/docs/http/ngx_http_core_module.html#internal) 指令:

```nginx
location /internal-path/ {
    internal;  # 只能内部跳转访问
    return 200 "This is an internal path.";
}
```

或者将 `location` 以 `@` 开头,作为 named location 使用:

```nginx
location @named-location {
    return 200 "This is a named location.";
}
```
变量与条件判断
set 指令可以设置变量的值,以上已有介绍。而 if 指令可以根据条件执行一组 rewrite 模块的指令。以下是一个示例:
if 中的条件也可以使用类似 Shell 的语法做文件存在性判断,例如 -d 判断目录是否存在,-f 判断文件是否存在,-x 判断是否有可执行权限等:
!!! tip "同时符合多个条件的判断" {#multiple-conditions}
Nginx 的 `if` 指令不支持 `&&` 或者 `||` 这样的逻辑运算,并且不支持 `if` 嵌套。如果需要同时满足多个条件,可以添加一个变量来实现:

```nginx
set $condition_met 0;
if ($http_user_agent ~* "^Mozilla") {
    set $condition_met 1;
}
if ($http_referer = "example.com") {
    set $condition_met "${condition_met}1";
}
if ($condition_met = "11") {
    return 403;  # 同时满足两个条件
}
```

不过,当条件更加复杂的时候,建议使用 `map` 指令来实现:

```nginx
map $http_user_agent $is_bad_ua {
    "~*^Mozilla" 1;
    "Go-http-client" 1;
    default 0;
}

map $http_referer $is_bad_referer {
    "~*example.com" 1;
    "~*example.edu" 1;
    default 0;
}

map "$is_bad_ua$is_bad_referer" $block_request {
    "11" 1;
    default 0;
}
```
!!! warning "谨慎在 location 中使用 if" {#caution-if-in-location}
曾有一篇[官方博客文章 "If is evil"](https://github.com/nginxinc/nginx-wiki/blob/master/source/start/topics/depth/ifisevil.rst) 讨论了在 `location` 块中使用 `if` 指令可能带来的问题。简单来讲,以下的使用场景是安全的:

- 在 `server` 块中使用 `if` 指令。
- 在 `location` 块中使用 `if` 指令,但只包含 `return` 或者 `rewrite ... last` 指令。

Nginx 在处理 `location` 块的 `if` 的时候,会创建一个临时的子 `location` 处理,因此如果在 `if` 中不做跳转的话,会有一些反直觉的行为。相关技术细节可阅读 [How nginx "location if" works](https://agentzh.blogspot.com/2011/03/how-nginx-location-if-works.html)。

如果真的需要复杂的条件判断,建议:

- 使用 `try_files` 指令结合 `internal` location,在文件/文件夹不存在时跳转到特定的 location 处理。
- 使用 `map` 指令对变量进行条件映射。
- 使用 Lua 脚本实现复杂逻辑。
日志
Nginx 对日志提供了完善的支持,其中核心模块提供了 error_log,HTTP 模块提供了 access_log 指令,分别用于配置错误日志和访问日志。默认的配置一般如下:
!!! warning "不要写 error_log off" {#do-not-use-error-log-off}
`access_log` 支持 `off` 参数,表示关闭访问日志,但是 `error_log` 不支持 `off` 参数。如果写了 `error_log off`,Nginx 不会报错,看起来也能正常运行,但是实际上错误日志会被写入到**名为 `off` 的文件**中(默认情况下,路径会是 `/usr/share/nginx/off`)。很多时候要等待 `off` 这个文件变得非常大,才会发现问题所在。

如果需要完全关闭错误日志,可以将 `error_log` 输出到 `/dev/null`,并指定等级为 `crit` 以减少 nginx 尝试写入日志的频率:

```nginx
error_log /dev/null crit;
```
访问日志默认的格式是 combined,类似如下:
当然,其支持使用 log_format 自定义日志格式,以下给出 combined 的定义,以及输出 JSON 格式日志的示例:
log_format combined '$remote_addr - $remote_user [$time_local] '
                    '"$request" $status $body_bytes_sent '
                    '"$http_referer" "$http_user_agent"';

log_format ngx_json escape=json '{'
    '"timestamp":$msec,'
    '"clientip":"$remote_addr",'
    '"serverip":"$server_addr",'
    '"method":"$request_method",'
    '"scheme":"$scheme",'
    '"url":"$request_uri",'
    '"status":$status,'
    '"size":$body_bytes_sent,'
    '"resp_time":$request_time,'
    '"http_host":"$host",'
    '"referer":"$http_referer",'
    '"user_agent":"$http_user_agent",'
    '"request_id":"$request_id",'
    '"proto":"$server_protocol"'
    '}';

access_log /var/log/nginx/access_json.log ngx_json;
escape=json 参数会假设变量会出现在 JSON 字符串中,并由此进行 JSON 转义。
访问日志也支持条件输出,例如下面这个将 HTTP 403 响应分开记录到单独日志文件的示例:
map $status $log_403 {
    403 1;
    default 0;
}

map $log_403 $log_normal {
    0 1;
    default 0;
}

access_log /var/log/nginx/access_403.log combined if=$log_403;
access_log /var/log/nginx/access.log combined if=$log_normal;
Lua
由 OpenResty 团队维护的 ngx_http_lua_module 提供了非常强大的 Lua 支持,可以在 Nginx 处理请求的各个阶段运行 Lua 脚本,实现复杂的逻辑。此外,Nginx 官方维护的 ngx_http_js_module (njs) 也提供了类似的使用 JavaScript 脚本的功能,但就目前而言,Lua 模块的生态更加丰富,功能也更强大。
Lua 语言简介
Lua 是一种轻量的脚本语言,可以轻松集成到其他应用程序中,并且在 LuaJIT 的支持下,可以达到非常好的性能,常被用于游戏开发,以及各种需要用户自定义运行逻辑的场景。
Lua 基础语法
以下给出一个简单的 Lua 代码示例,展示基本的语法,可以在 Lua 解释器中运行。如果希望进一步学习 Lua,可以参考官方文档以及 Programming in Lua 一书。
-- 这是注释

local version = "1.0"  -- 使用 local 定义局部变量
if version ~= "1.0" then  -- ~= 表示不等于
    print("Version is not 1.0")
else
    print("Version is 1.0")
end
if something_not_defined == nil then  -- nil 表示空值/未定义
    print("A nil variable")
end

-- 字符串正则匹配与替换
local str = "Hello, Lua 123!"
local match = string.match(str, "%d+")
local match_2 = str:match("%d+")  -- 冒号语法糖,等价于 str.match(str, pattern)
local new_str = str:gsub("%d+", "456"):lower()  -- gsub 替换,lower 转小写
assert(match == match_2, "Matches should be equal")
print(match)
print(new_str)

-- Lua 中的表(table)可以用来表示数组、字典(键值对)等数据结构
local map = {
    {"host", "host"},
    {"server", "server_addr"},
    {"ts", "msec"},
    {"ip", "remote_addr"},
    {"ua", "http_user_agent"}
}  -- 定义一个表(数组)
local another_map = {
    host = "www.example.com",  -- 或者 ["host"] = "www.example.com"
    server_addr = "www.example.com",
    msec = 1234567890,
    remote_addr = "127.0.0.1",
    http_user_agent = "Mozilla/5.0"
}  -- 定义一个表(字典)
local result = {}

-- 循环,使用 ipairs 遍历表,类似 Python 的 enumerate
for _, pair in ipairs(map) do
    -- 使用 table.insert 向表中添加元素
    -- 使用 .. 进行字符串连接
    -- Lua 的下标从 1 开始,不是 0!
    table.insert(result, pair[1] .. "=" .. another_map[pair[2]])
end

print(table.concat(result, "\n"))  -- 使用 table.concat 将表元素连接成字符串

local function factorial(n)  -- 定义函数
    if n == 0 then
        return 1
    else
        return n * factorial(n - 1)
    end
end

print("Factorial of 5 is " .. factorial(5))
Lua 模块
最简单的代码复用的方式是使用 loadfile() 函数直接加载另一个 Lua 脚本文件:
local f = loadfile("some_script.lua")
if f then
    f() -- 执行加载的脚本
else
    print("Failed to load some_script.lua")
end
但是这样做存在很多问题:每次调用 loadfile 都会重新加载,并且无法利用到 LuaJIT 的编译缓存机制。因此更推荐的做法是包装成 Lua 模块,然后使用 require 导入。以下是调用 cjson 模块解析 JSON 的示例:
-- 导入 cjson 模块用于处理 JSON
-- Debian 下包为 lua-cjson
local cjson = require "cjson"
local example = "{\"key1\":\"value1\",\"key2\":2}"
local decoded = cjson.decode(example)
print(decoded["key1"])
为了包装为模块,Lua 代码需要小幅修改。一个非常简单的模块示例如下:
local _M = {}

local function double_var(a)
    return a + a
end

function _M.double_plus(a, b)
    local aa = double_var(a)
    local bb = double_var(b)
    return aa + bb
end

return _M
Nginx 中 Lua 的安装配置
要在 Nginx 中使用 Lua 脚本扩展能力的话,需要安装 Lua 模块。最简单的方式是使用 OpenResty,它集成了 Nginx 和 Lua 模块,并且预置了很多常用的第三方 Lua 库。如果不希望使用 OpenResty,也可以自行安装 Lua 模块(libnginx-mod-http-lua 包)。安装此包后,/etc/nginx/modules-enabled/ 会自动引入对应的配置:
$ readlink /etc/nginx/modules-enabled/50-mod-http-lua.conf
/usr/share/nginx/modules-available/mod-http-lua.conf
$ cat /etc/nginx/modules-enabled/50-mod-http-lua.conf
load_module modules/ngx_http_lua_module.so;
与 sites-enabled 类似,modules-enabled 目录下的配置文件会被 Nginx 主配置文件自动包含。配置后可以使用以下 location 测试:
其中 content_by_lua_block 控制了请求的响应内容,而 ngx.say 则会直接向响应中写入内容。
执行阶段
有一张经典的图展示了 Nginx 处理请求的各个阶段中,Lua 脚本可以插入的位置:

图来自 openresty/lua-nginx-module 仓库
有关 Nginx 处理请求的各个阶段的介绍,可以参考 Nginx 的 Development guide。
如果不熟悉相关的阶段的话,那么在写代码的时候可能会遇到非预期的行为。这是一个我们实际遇到的例子:
server {
    # ...

    access_by_lua_file /etc/nginx/lua/access.lua;
    header_filter_by_lua_file /etc/nginx/lua/header_filter.lua;
    log_by_lua_file /etc/nginx/lua/log.lua;

    location /lua-test0 {
        return 200;
    }

    location /lua-test1 {
        try_files $uri $uri/ =404;
    }
}
那么在访问 /lua-test0 的时候,上面三个 Lua 脚本都会被执行吗?/lua-test1 呢?答案是:对 /lua-test1,这三个脚本都会被执行,但是对 /lua-test0,access_by_lua_file 不会被执行,其他两个会。这是因为 return 在 rewrite 阶段执行重定向,结束了对请求的处理,因此后面的 access 阶段的脚本不会被执行。但是 header_filter(输出过滤的一部分,未在 Phase 中列出,但是会在 content 生成后,发送数据前执行)和 log(日志记录)阶段仍然会被执行,因此就产生了和上图矛盾的现象。
存储与共享状态
在编写脚本时我们常见的需求有:
- 在某个阶段存储的状态需要在后续的阶段使用
- 多个 worker 进程之间需要共享状态
以下介绍 Lua 模块提供解决方案。
ngx.ctx 与 ngx.var
ngx.ctx 是可以存储任意 Lua 变量的表,在当前请求有效。使用方法类似如下:
location /example {
    access_by_lua_block {
        ngx.ctx.start_time = ngx.now()
        ngx.sleep(0.1)
    }

    log_by_lua_block {
        local duration = ngx.now() - ngx.ctx.start_time
        ngx.log(ngx.ERR, "Request took " .. duration .. " seconds")
    }
}
可以看到,这里在 access 阶段存储了请求的开始时间,并在 log 阶段计算并输出了请求的持续时间。
不过有一个无法忽视的问题是:如果请求使用了内部跳转(internal redirect,例如 try_files、error_page、index),那么 ngx.ctx 会被清空。因此,退而求其次,需要使用 Nginx 的变量机制来存储数据。可以使用 ngx.var.VARIABLE 来访问 Nginx 变量,不过 ngx.var 相比 ngx.ctx 有一些限制:
- 性能相比
ngx.ctx较差。 - 每次访问
ngx.var都会产生一次内存分配,因此编程时需要先获取到本地变量再使用。 ngx.var只能存储字符串或数字。- 需要提前使用
set定义变量。
对于需要使用 ngx.var 存储复杂 Lua 变量的场景,可以使用第三方的 lua-resty-ctxdump。其原理是:将实际内容保存在模块内部的 memo 表中,而需要存储在 ngx.var 里面的只是 memo 表的 key(数字)。
共享 dict
针对不同的工作进程之间需要共享状态的场景(例如统计某个 location 的访问状态),Lua 模块提供了 lua_shared_dict 指令,可以在 http 块中定义一个共享 dict 区域:
在 Lua 代码中使用 ngx.shared.DICT 调用。
!!! lab "获取共享 dict 的剩余空间" {#shared-dict-space}
对比较复杂的需求场景下,获取共享 dict 的剩余空间是有必要的——可以据此添加监控告警,防止共享 dict 被写满导致服务异常。请编写一个 Lua 脚本,当用户访问 `/shared-dict-info` 时,返回共享 dict 的总大小和剩余空间。

如果需要测试,可能还需要添加一些其他的 `location` 来向共享 dict 中写入/删除数据。